
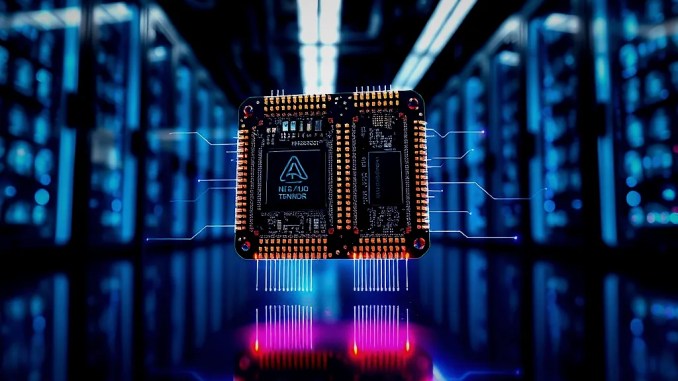
Google stellte die neue Generation AI-Prozessoren vor
Google hat kürzlich zwei neue TPU-Systeme angekündigt: TPU 8tx und TPU 8i Max. Beide Plattformen erweitern das TPU-Portfolio und zielen auf unterschiedliche Anforderungen: Datenschutzfokussierte, kleine bis mittlere Trainingsaufgaben einerseits und speicherintensive, agenten- und multimodale Anwendungsfälle andererseits. Google optimierte beide Designs, um Datenbewegung zu reduzieren, Speicher- und Rechenkapazität zu erhöhen und für typische Entwickler-Workflows messbare Vorteile zu liefern.
TPU 8tx: Was Unternehmen bei sinnvollen Daten gewinnen
TPU 8tx ermöglicht Modellaktualisierungen direkt dort, wo sinnvolle Daten verbleiben. Das System trennt sich bewusst von Workloads, die große, verteilte Trainingsläufe erfordern, und bietet stattdessen Merkmale, die praktische Compliance- und Latenzvorteile schaffen:
Verarbeitung am Datenort: Sie geziden die Übertragung sensibler Patienten-, Finanz- oder personenbezogener Daten in fremde Infrastrukturen. In der Praxis reduziert sich der Audit-Aufwand und senkt die Chance für Datenlecks.
Optimierung für häufige, kleine Updates: Modelle mit wenigen Parametern, die regelmäßig nachtrainiert werden (z. B. Personalisierungsmodelle, Betrugserkennungspatches), laufen auf 8tx schneller und kosteneffizienter, weil Speicher und Kommunikationspfade darauf abgestimmt sind.
Hardware‑Isolation und Verschlüsselung: Die Plattform liefert konfigurierbare Isolationsebenen und Hardwareverschlüsselung, die regulatorische Vorgaben wie HIPAA‑ähnliche Anforderungen in Branchen vereinfachen.
TPU 8i Max: Für Agenten, lange Sequenzen und große Modelle
TPU 8i Max Addresssiert Workloads mit großem Speicherbedarf und hohem Rechenaufwand. Typische Anwendungsfälle zeigen, wie die Architektur derse Effizienzvorteile bringt:
Multimodale Agenten: Wenn ein KI-Agent gleichzeitig Codebasen analysiert, Videos interpretiert und Konversationen führt, erfordert das anhaltende Speicherabbildungen und hohe Aggregationsbandbreite – genau hier beschleunigt 8i Max das Zusammenspiel.
Lange Sequenzen (Video, Dokumente): Bei stundenlangen Videos oder umfangreichen rechtlichen Dokumenten verhindert die erweiterte Speicheradressierung auf 8i Max häufiges Segmentieren und Re-Sharding. Die reduzierte Gesamtlatenz und Codekomplexität für Vorverarbeitungspipelines.
Skalierbares Training und Batch-Inferenz: Für groß angelegte Offline-Trainings und massenhafte Batch-Inferenzen nutzt 8i Max parallele Recheneinheiten effizienter und senkt dadurch die Gesamtbetriebskosten pro Token oder pro Stichprobe.
Wie Google mit TPUs Nvidia
Diese Integration ermöglicht Latenz- und Kostenvorteile für Kunden, die auf Google Cloud laufen oder Hybrid-Szenarien mit Google-verwalteten Knoten nutzen.
Segmentierte Produktgestaltung: Anstatt einen Allzweckbeschleuniger zu bauen, differenziert Google klar: 8tx für Datenschutz‑ und Niedriglatenz‑Updates, 8i Max für speicherintensive, komplexe Analysen. Unternehmen wählen so gezelter nach Nutzfall.
Softwareökosystem: TensorFlow‑Optimierungen, Compiler‑Pipelines und Laufzeitbibliotheken bleiben zentrale Hebel. Google erweitert diese Schichten, damit Entwickler weniger Aufwand beim Portieren und Tuning haben.
Entscheidungshilfe: Welches TPU für welchen Einsatz?
Kokrete Auswahlkriterien, die Sie systematisch prüfen sollten:
1) Daten‑Sensitivität und Compliance: Wenn Daten nicht die Rechenumgebung verlassen dürfen, schlägt die Waage zugunsten von TPU 8tx aus. Beispiel: Ein Kliniknetzwerk aktualisierte Dosisvorhersagemodelle mehrmals täglich; TPU 8tx ermöglicht das ohne Datenexport.
2) Sequenzlänge und Speicherbedarf: Bei flüssiger Verarbeitung langer Videos oder ganzer Code-Repositories ist TPU 8i Max effizienter: weniger Checkpoints, geringerer I/O-Overhead.
3) Trainingsprofil: Kurz laufende, häufige Fine‑Tuning‑Jobs – TPU 8tx. Große, einmalige Pre-Training-Runs oder massive Batch-Inferenzen – TPU 8i Max.
4) Gesamtbetriebskosten: Kalkulieren Sie nicht nur Hardware-Kosten, sondern auch Energie, Personalkosten für Optimierung und potenzielle Interessenten durch veringerte Datenübertragungen.
Praxisbeispiele: Wie sich Auswirkungen in echten Projekten zeigen
Beispiele aus zwei Branchen verdeutlichen das Nutzenspektrum:
Gesundheitswesen: Ein Anbieter verwendet TPU 8tx, um Modelle zur Risiko-Stratifizierung local zu aktualisieren. Ergebnis: Compliance-Audits werden einfacher, die Modellaktualisierung pro Datensatz beschleunigt sich, und es fallen Übertragungsgebühren an.
Medien- und Unterhaltungsbranche: Ein Produktionsstudio setzt TPU 8i Max für automatische, stichpunktartige Zusammenfassungen von Langformat-Videos ein. Die reduzierte Segmentierung spart Stunden an Batch-Vorverarbeitung pro Projekt.
Schritte zur Migration: Konkreter Fahrplan
Befolgen Sie diese Schritte, um Risiko und Zeitaufwand bei der Einführung zu minimieren:
1. Bestandsaufnahme: Messen Sie Modellgrößen, Batch-Profile und Datenbewegungsmuster. Erfassen Sie, welche Pipelines regelmäßig umgeschult werden müssen.
2. Sicherheits‑Check: Legen Sie fest, welche Daten welche Schutzstufen benötigen; Klären Sie Verschlüsselungs- und Logging-Anforderungen.
3. Proof-of-Concept: Starten Sie mit einem Piloten, der typische Lasten simuliert — z. B. ein einwöchiger Live-Test für kontinuierliche Fine-Tunes auf 8tx oder ein 48-Stunden-Batchlauf auf 8i Max.
4. Softwareanpassung: Portieren Sie Modelle mit unterstützten Frameworks, quantisieren und testen Sie Ihr Performance-Regime. Nutzen Sie Google-optimierte Bibliotheken und Profiler fürs Feintuning.
5. ROI-Messung und Rollout: Vergleichen Sie Kosten, Durchsatz und Latenz vor und nach der Migration; Rollen Sie stufenweise aus, beginnend bei nicht‑kritischen Pipelines.
Häufig gestellte Fragen kurz beantwortet
Was unterscheidet TPU 8tx und TPU 8i Max Grundlegend? TPU 8tx optimiert für Datenschutz, niedrige Latenz bei häufigen kleinen Trainings; TPU 8i Max skaliert für lange Sequenzen, hohe Speicheranforderungen und massives Batch-Processing.
Wann ist ein Wechsel von Nvidia‑GPU sinnvoll? Wir sollten Sie unterstützen, wenn Ihre Workloads von Google‑spezifischen Integrationen profitieren, wenn die Datenlokalität kritisch ist oder wenn die TPU‑Spezifikationen im Benchmark klare Vorteile zeigen.
Wie validiere ich die Wahl vor Produktionsaufnahme? Implementieren Sie Pilotläufe unter realen Datenbedingungen, führen Sie A/B-Tests durch und dokumentieren Sie Metriken zu Kosten, Latenz und Modellqualität.
Zusammenfassung: Bewertungsrahmen für die Auswahl
Treffen Sie die Wahl anhand messbarer Kriterien: Datenschutzanforderungen, Sequenzlänge, Trainingsmuster und Total Cost of Ownership. Verwenden Sie Pilotprojekte, um praktische Unterschiede zwischen TPU 8tx und TPU 8i Max zu quantifizieren, bevor Sie großflächig migrieren.
Google stellt neue Tensor-Beschleuniger vor: Leistungsstärkerer KI-Chip, Optimiert für Energieeffizienz und große Modelle.

İlk yorum yapan olun